En este artículo
Un asistente que responde con los documentos de una organización parece simple desde afuera: se hace una pregunta y aparece una respuesta con su fuente. Por dentro hay decisiones de diseño que separan un demo atractivo de un sistema que se puede poner en producción con datos sensibles. Este artículo explica cómo funciona Raggo, el asistente con IA de Coresis, paso a paso y con sus límites a la vista. Si buscas la versión para decisores, está en la página de producto de Raggo.
Qué es RAG, en una frase
RAG (generación aumentada por recuperación) combina un modelo de lenguaje con información recuperada de fuentes externas, como describe el trabajo de Lewis y colaboradores. En Raggo, el objetivo es que la respuesta se sustente en los fragmentos autorizados de la organización, en lugar de depender únicamente del conocimiento previo del modelo. Eso permite citar fuentes y reduce las respuestas inventadas. No las elimina por sí solo, y por eso Raggo añade varias barreras que se describen más abajo.
1. Ingesta: de documentos a conocimiento consultable
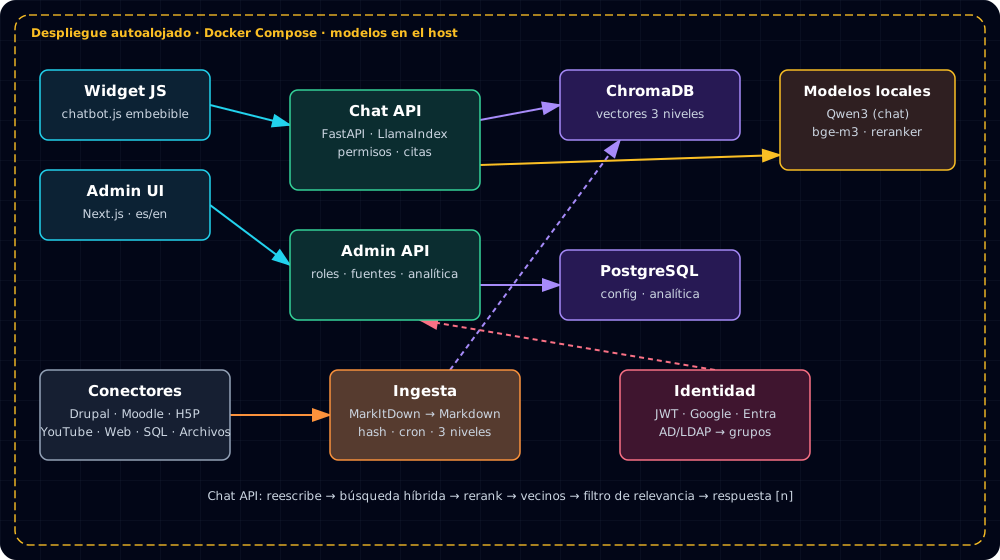
Los conectores leen las fuentes: Drupal, Moodle, H5P, transcripciones de YouTube, rastreo de sitios web, consultas SQL y carga de archivos. Los documentos (PDF, Word, PowerPoint, Excel, CSV, HTML, XML, JSON, texto y Markdown) se convierten a Markdown con MarkItDown, para trabajar con un formato uniforme.
El contenido se indexa en tres niveles: documento, sección y fragmento. Así, una pregunta amplia encuentra el documento correcto y una pregunta precisa encuentra el párrafo exacto. Cada documento tiene una huella (hash) de su contenido: en cada sincronización programada solo se reprocesa lo que cambió, lo que mantiene el índice al día sin recalcularlo todo.
2. Búsqueda: significado y palabras exactas
Raggo combina dos tipos de búsqueda. La búsqueda semántica (embeddings bge-m3) encuentra textos que significan lo mismo aunque usen otras palabras, y funciona entre español e inglés. La búsqueda por palabras clave atrapa términos exactos como códigos, siglas o nombres propios. Los resultados de ambas se fusionan y un modelo de reordenamiento (bge-reranker-v2-m3) los vuelve a ordenar según su relevancia real para la pregunta. Después se agregan los fragmentos vecinos para darle contexto al modelo.
3. Permisos: filtrar antes de buscar
La decisión de diseño más importante en entornos institucionales es esta: los permisos se aplican antes de puntuar los resultados. Cada pregunta llega con una identidad (un token firmado de la página que incrusta el asistente, o un grupo de Google, Microsoft Entra o Active Directory). Esa identidad se traduce a grupos de conocimiento permitidos, y la búsqueda solo ocurre dentro de ellos. El diseño excluye de la recuperación y del contexto del modelo los grupos no autorizados. Su eficacia debe verificarse con las identidades, las fuentes y los cambios de permisos de cada despliegue; no basta con pedir al modelo que ignore contenido restringido. Los usuarios anónimos se limitan a grupos públicos.
4. Respuesta: citas y puerta de relevancia
Antes de generar texto, una puerta de relevancia decide si lo recuperado realmente responde la pregunta. Si no es así, se devuelve un mensaje configurable ("no encontré información") y la pregunta se registra como no resuelta. Si es relevante, el modelo redacta la respuesta con citas numeradas [1], [2] que enlazan a la fuente con un fragmento. Las preguntas de seguimiento se reescriben para que tengan sentido por sí solas.
5. Modelos locales y privacidad
El modelo de chat (Qwen3.6-27B), el de embeddings y el de reordenamiento se ejecutan con llama.cpp en la infraestructura del cliente (Ollama es una alternativa soportada). Ninguna conversación se envía a un proveedor externo de IA. El dimensionamiento de GPU y memoria debe validarse según la cuantización del modelo, el tamaño del contexto y las consultas simultáneas; el número de parámetros por sí solo no define el hardware necesario. Las credenciales de los conectores se cifran en reposo; la analítica no guarda identificadores de usuario, oculta correos y teléfonos, usa sesiones con hash con sal y conserva datos 90 días por defecto; existen endpoints de exportación y borrado de datos por titular.
Cómo medimos la calidad (y qué no dicen los números)
Evaluamos con un corpus sintético de 110 registros, 90 preguntas dentro del contenido y 8 fuera, en español e inglés. El reordenamiento subió la calidad de recuperación (nDCG@10) de 0,86 a 0,93, y en preguntas difíciles parafraseadas de 0,44 a 0,70. Las 8 preguntas fuera del contenido fueron rechazadas correctamente. La búsqueda toma unos 0,4 s con reordenamiento (50 ms sin él) y una respuesta completa unos 6 a 9 s en el entorno de pruebas de Coresis con GPU RTX 5080.
La ficha de Raggo publica el contexto de estas pruebas internas. nDCG@10 evalúa el orden de relevancia de los resultados recuperados: 0,93 no significa que el 93 % de todas las respuestas sea correcto. El rechazo de esas ocho preguntas tampoco garantiza el rechazo de cualquier pregunta fuera de alcance. Estas cifras son de un entorno de pruebas con datos de demostración. Sirven para comparar decisiones de diseño entre sí, no para prometer un resultado en tu organización: con contenido real, la calidad depende de cómo esté escrito, estructurado y actualizado. Por eso toda implementación empieza midiendo con tus propios documentos.
Despliegue
Raggo se entrega con Docker Compose: API de chat y de administración (FastAPI), consola de administración (Next.js), ChromaDB como almacén de vectores y PostgreSQL para configuración y analítica. Los servidores de modelos corren en el host. El asistente se incorpora al sitio con un widget de JavaScript de dos líneas, y hay una página de resultados de búsqueda con filtros para quienes prefieren ver resultados sin respuesta generada. Hoy no ofrecemos despliegue en nube gestionada ni canales como Slack, Teams o WhatsApp.
Qué validar con los documentos de tu organización
Un piloto debe comprobar la cadena completa, no solo que el chat devuelva texto. Conviene acordar con el área usuaria y el equipo de seguridad una muestra de preguntas y los criterios para aceptar o detener el despliegue:
- Fuente y vigencia: la respuesta debe apoyarse en el documento correcto, incluir una referencia utilizable y respetar la versión vigente.
- Permisos: el mismo usuario no debe recuperar una fuente después de perder su acceso; compare también perfiles con distintos grupos.
- Ausencia de evidencia: incluya preguntas que ningún documento responde y revise la abstención.
- Actualización: compruebe qué ocurre al modificar o retirar una fuente, sin dar por hecho que sincronizar equivale a actualizar al instante.
- Operación: mida latencia, concurrencia, revisión humana y mantenimiento con el volumen esperado.
También hay que probar documentos con instrucciones maliciosas. La guía de OWASP sobre inyección de instrucciones explica por qué RAG no resuelve este riesgo por sí solo. Las citas, los filtros y los modelos locales son controles que deben evaluarse, no una garantía absoluta de seguridad o exactitud.
Para traducir estas pruebas a una decisión de negocio, consulte qué beneficios de IA documental medir. Si el caso exige modificar datos o ejecutar procesos, evalúe por separado los agentes de IA con acciones controladas: no es la misma responsabilidad que consultar documentos.
¿Te sirve para tu caso?
Si tu organización tiene conocimiento disperso, requisitos de privacidad y personas que necesitan respuestas verificables, conversemos. Conoce Raggo o agenda una demo con tus propios documentos. También puedes leer sobre RAG privado para IA con datos institucionales.